

Datakvalitet afgør, om en AI-agent giver dig et rigtigt eller et overbevisende forkert svar. Hvor rodet data før gav en synlig fejl, fylder en agent hullerne ud og svarer, som om alt var korrekt. Abakion gennemgår de klassiske datakvalitetskrav, de nye begreber som semantisk entydighed, handlingsparathed og kontekstuel dokumentation, de skjulte problemer agenter afslører, samt spørgsmålet om GDPR og ejerskab.
Se hvordan en autonom agent fungerer
Anders fra Microsofts CAT-team viser Abakion tre agenter, han bruger dagligt: Cowork GitHub Copilot og autopiloten Scout,
Sådan bygger du en Agent med Copilot Studio
Copilot Studio er Microsofts værktøj til at bygge agenter. Abakion giver en rundtur i interfacet og gennemgår alle byggeklodserne.

Sådan virker Agenter i Business Central
Abakion laver demo af Microsofts tre standardagenter til Business Central: Payables agenten, Sales Order agenten og Expense agenten.
Sådan virker Agent Playground i Business Central
Agent Playground er en funktionalitet, hvor man kan bygge agenter, der lever inde i selve brugergrænsefladen i Business Central.
Sådan bruger du AI sammen med Business Central
Abakion viser, hvordan du konkret bruger AI sammen med Business Central til at give medarbejderen sit fag tilbage, gennem fire små værktøjer.
Forandringer og organisatorisk parathed
Forandringsledelse er den disciplin, alle godt ved er vigtig for at få projektet til at lykkes, men som de færreste får gjort noget ved.
Sikkerhed, rettigheder og governance af AI
Abakion gennemgår de fem Microsoft-portaler, IT skal have styr på, hvorfor en agent er en bruger og hvordan forretning og IT samarbejder.
Er dine data gode nok til AI og Agenter?
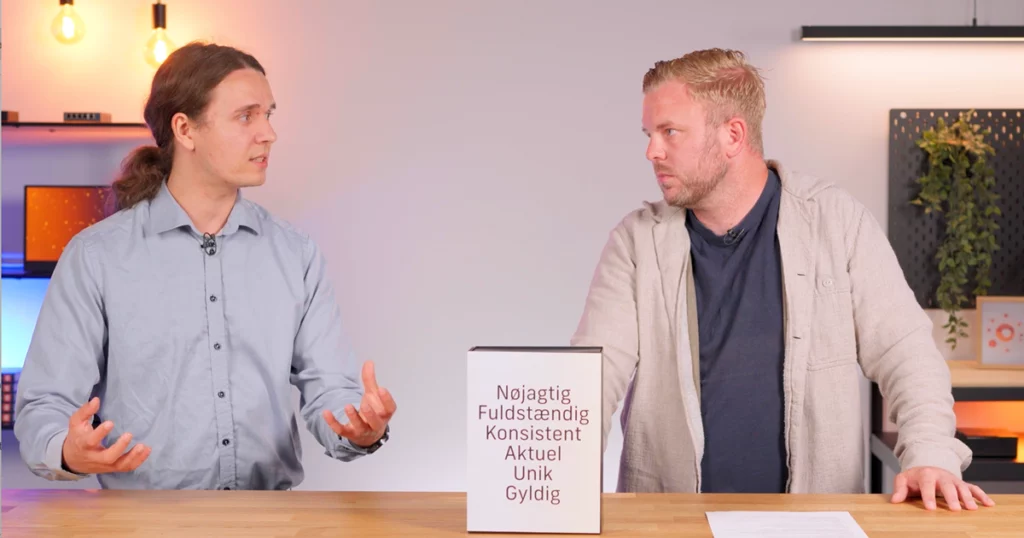
Datakvalitet afgør, om en AI-agent giver dig et rigtigt eller forkert svar. Abakion gennemgår de klassiske datakvalitetskrav.
Overvejelserne bag en AI-agent
Hvad skal du tænke over, før du bygger din egen AI-agent? Abakion gennemgår hele blueprintet for en agent i Copilot Studio.
Flow, Agent eller Hybrid: Vælg den rette metode
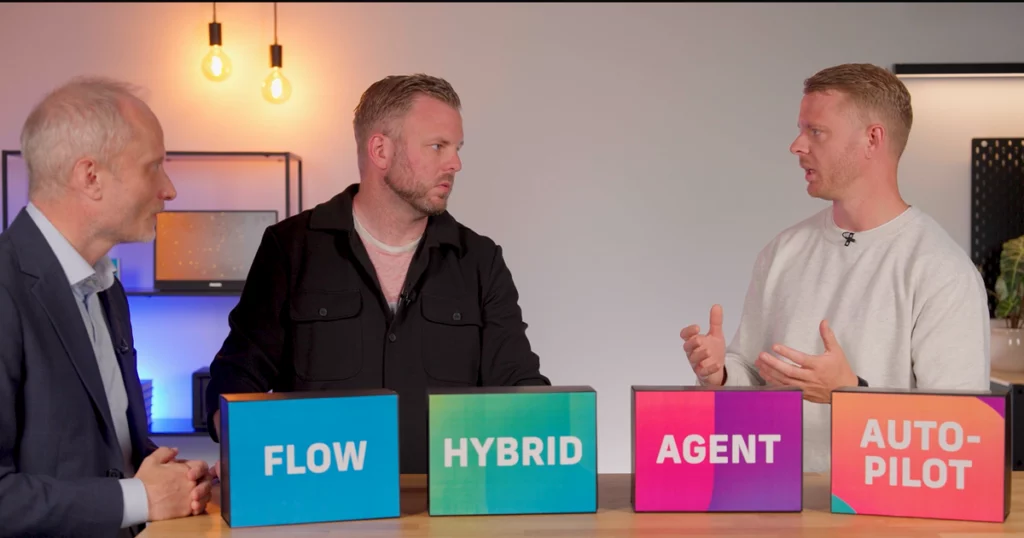
Ikke alle automatiseringer skal bygges med en AI-agent. Når du kaster dig ud i et optimeringsprojekt, kan du vælge mellem fire metoder.
Microsofts Agenter i Business Central
Søren Alexandersen, forklarer, hvordan Payables Agent virker, hvorfor Microsoft skifter fra OCR, og hvornår man skal bygge agenter selv.
Læg en business case for AI og Agenter
En business case for AI er et regnestykke over, hvad det koster, og hvad det giver tilbage, men værdien rummer mere end sparede kroner.
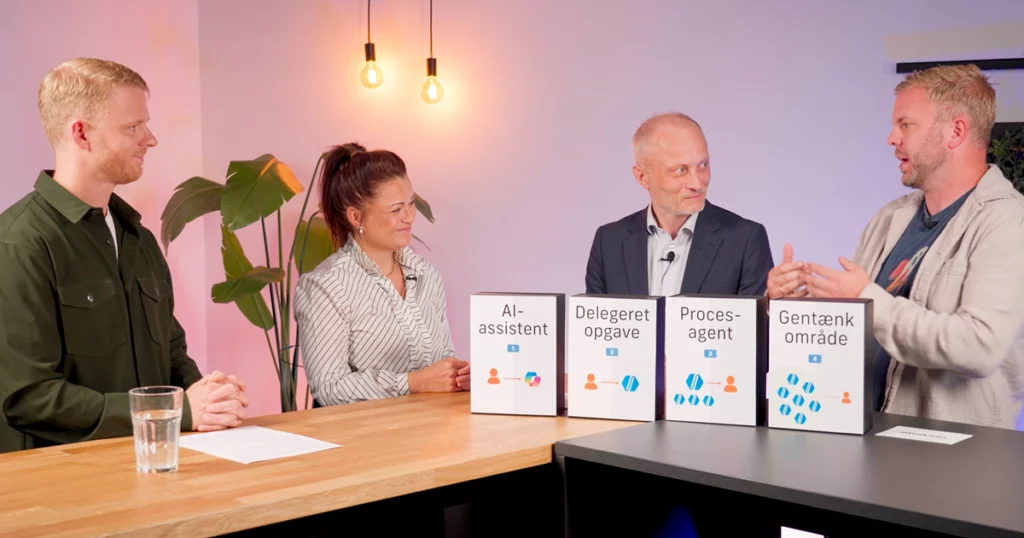
Lær at udvælge AI-projekter med størst potentiale
Abakion gennemgår fire ambitionsniveauer for AI, og forklarer, hvorfor du ikke kan springe direkte til det vilde niveau.
Brunatas erfaring med at optimere med AI
Morten Densam deler med Abakion, hvordan Brunata griber optimering med AI an, hvad der virker, og hvor faldgruberne ligger.
Diabetesforeningens erfaring med at udbrede AI
Halvdelen af Diabetesforeningens medarbejdere bruger AI hver dag, og det er ikke sket, fordi ledelsen har beordret det.
Læg en strategi for AI-omstilling
Alle virksomheder har brug for en AI-strategi. Men det er væsentligt om du vil bruge AI, eller vil du drive en AI-omstilling?
Microsoft forklarer strategien for AI
Microsofts strategi for AI hedder Frontier Framework, Den deler arbejdet op i tre måder at bruge AI på. Hør her, hvordan du kommer i gang.
AI-ordbogen: Alle begreberne du skal kende
Mange kigger på dig som ERP-administrator og forventer, at du kender alle AI- og agent-begreber, du skal kende, før du lægger en AI-plan.

Hallucinerer moderne AI-modeller?
Sjældnere end folk tror. Folk har snakket meget om hallucinationer i forbindelse med AI, men med de nye modeller er det sjældent det egentlige problem. Det, mange oplever som en hallucination, er i virkeligheden, at de ikke forstår det svar, der kommer, fordi de ikke har forstået den kontekst, agenten svarer ud fra.
Begrebet er blevet meget bredt og dækker nærmest alt, der giver et svar, man ikke forventede. I de tidlige modeller kunne man opleve svar, der var helt ude i skoven, hvor det ikke engang var sprog, man kunne tolke. Den tid er i høj grad ovre. Til gengæld har agenter et stort korpus af generel viden, og hvis den ikke kan finde den specifikke viden, den har brug for, kan den risikere at bruge den generelle viden til at svare, så man rammer forbi hinanden. Men en nyere model opfinder ikke bare et CVR-nummer, der ikke findes. Den svarer ud fra en form for viden, den har, eller siger, at den ikke kan svare.
Hvad betyder garbage in, gospel out?
Garbage in, gospel out betyder, at dårlige data giver et forkert svar, som brugeren opfatter som sandt. Alle kender begrebet shit in, shit out: fodrer du med dårlige data, får du dårlige svar. Men Andreas bruger en skarpere variant, garbage in, gospel out. Pointen er, at agenter har en tendens til at opføre sig, som om de er sat i verden for at tilfredsstille den, der spørger, så de for alt i verden giver dig det svar, du håber på.
Hvis man havde rodet data, kunne man før i tiden relativt let se det i rapporter og funktioner, der byggede direkte på data. Et rødt kryds eller et tal ude i vejret afslørede fejlen. Problemet er, at AI er så god til at fylde hullerne ud, at den giver sit bedste bud, selvom den ikke har det fulde overblik. Buddet kan være korrekt, men det kan bestemt også være forkert, og det er meget sværere at se, fordi det ligner noget, der generelt er korrekt. En bruger uden den nødvendige baggrundsviden opdager ikke, at der kommer garbage ud, og opfatter det derfor som gospel, som valid og god information.
Hvad er forskellen på aktuelle og gyldige data?
Aktuelle data handler om, at data er opdaterede, mens gyldige data handler om, at forretningens logik er fastlagt. Der er seks klassiske krav til god datakvalitet: data skal være nøjagtige, fuldstændige, konsistente og så videre. To af dem fortjener en ekstra bemærkning, når det handler om AI.
Aktuelle data. Har man data, der opdateres en gang i timen, men opdateringsmekanismen er stoppet for to dage siden, så arbejder man med uaktuelle data, uden at agenten nødvendigvis kan vide det. Det er mere eller mindre som at have forkert data, bortset fra at data engang var rigtig. Det svarer til, at en kundeansvarlig har pligt til at opdatere adressen i systemerne, når en kunde flytter kontor.
Gyldige data. Har en forretning en regel om, at en fakturering tildeles en afdeling, og en medarbejder flytter afdeling, skal det være specificeret, om faktureringen flytter med eller bliver hos afdelingen. Når man siger fakturering eller profit, skal det betyde en bestemt ting. Man må ikke blande termerne sammen. Skriver nogen omsætningstallet i et felt, der hedder profit, hjælper det ikke noget. Det er især her, man kan træde forkert med AI, for har man en måde at udregne omsætning på, som ikke er identisk med alle andres, vil AI nok falde tilbage på at gøre det, som alle andre gør.
Hvilke datakvalitetskrav gælder for AI-agenter?
Der er de seks klassiske krav, og oveni er der kommet nye krav, som først bliver synlige, når data skal bruges af en agent. Skemaet samler dem:
| Krav | Type | Hvad det betyder for en agent |
| Nøjagtige | Klassisk | Data skal være korrekte |
| Fuldstændige | Klassisk | Der må ikke mangle data |
| Konsistente | Klassisk | Data skal være ens på tværs |
| Aktuelle | Klassisk | Opdateringsmekanismen må ikke være stoppet |
| Gyldige | Klassisk | Termer som fakturering og profit skal være fastlagt |
| Semantisk entydige | Ny | Samme term skal betyde det samme på tværs af systemer |
| Handlingsparate | Ny | Data skal være klar til, at agenten kan handle på dem |
| Kontekstuelt dokumenterede | Ny | Metadata og aliaser skal forklare, hvad data er |
De klassiske krav har altid været vigtige. De tre nye er dem, de fleste opdager, når de har arbejdet med AI i mere end fem minutter.
Hvad er semantisk entydighed?
Semantisk entydighed er, at det samme kan hedde forskellige ting i forskellige systemer, mens forskellige ting kan hedde det samme. Det kan hedde kunder i ét system, virksomheder i et andet og customers eller accounts i et tredje.
Når man begynder at knytte systemer sammen, opdager folk ofte, at de længe har snakket om noget, de troede var det samme, men i virkeligheden var forskellige ting. Aktive kunder kan måles på forskellige måder: er en kunde, der er under salg, men endnu ikke har købt, en aktiv kunde? En salgsafdeling og en finansafdeling kan svare hver sit. Det handler om entydighed i fagtermer og forretningstermer, og det skrives sjældent ned sort på hvidt, fordi alle i økonomiafdelingen har fået en indflyvning, der gør, at de bare ved det.
Et konkret eksempel: du kan trække en liste ud af et ERP-system som Business Central, hvor kolonnen hedder kunder. Den samme liste ud af et CRM-system hedder pludselig accounts, og i et Excel-ark har en tredje kaldt kolonnen firmaer. For et menneske er det åbenlyst det samme. Men afleverer du de tre til en agent, betragter den dem som tre vidt forskellige ting. Man håber, at data er præcis nok til, at agenten ikke behøver at gætte, hvilke kolonner der er de samme, for ellers kobler den dem forkert sammen. Termer som sales to og bill to, altså leverance- og betalingskunder, skal derfor specificeres, når man snakker om kunder.
Hvad er handlingsparathed og kontekstuel dokumentation?
Handlingsparathed betyder, at data ikke længere bare skal være korrekte, men også klar til, at man kan handle på dem. Kontekstuel dokumentation er metadata, der forklarer, hvad data er, og som nu også er blevet datakvalitet for den gængse bruger.
Kontekstuel dokumentation handler om kolonnenavne, filnavne og alt det, der forklarer, hvad data er. Alle, der har kodet, ved, at dokumentation er ekstremt vigtigt, og at der ikke er noget værre end at overtage noget stort og komplekst, der ikke forklarer sig selv. Det er præcis det, man udsætter en agent for. Man kan se det, som om man på kontrakt hyrer en person til en opgave og fyrer den igen med det samme. Skal den næste agent ind, kan den ikke forstå sammenhængen, hvis den ikke står et sted.
Aliaser er et godt eksempel. I Abakion hedder business units i systemet netop business units, men mange kalder dem BU’er. Spørger folk om BU’er, kan AI ikke nødvendigvis gennemskue, at det betyder business units, afdelinger eller forretningsenheder. Pointen er, at vi skal blive bedre på tværs af organisationen til at afklare, hvad der er rigtigt. For laget, for kontoret og for de kørende sælgere kan sandheden være tre forskellige ting, og alle tre kan være rigtige. Derfor skal man give agenten den kontekst med, hvor man kommer fra, og hvad ens rolle, behov eller opgave er.
Gevinsten er stor. Du åbner data op for folk, som ikke forstår den bagvedliggende struktur. I stedet for at vide, at du skal ind i Business Centrals lagerstyringsmodul, kan du spørge i menneskesprog, hvor mange af en enhed du har på lager. Men det kræver, at data, agenten trækker fra, er dokumenteret og retvisende, for ellers ender folk, der ikke kan validere svaret, med et forkert svar i hånden. Og agenten kan handle: skriver du, at den skal bestille 50 nye, hvis lagerstatus er under 10, kan den oprette en indkøbsordre i ERP-systemet, forudsat at data bagefter opdateres, så den ikke bestiller igen næste gang.
Hvilke skjulte problemer afslører agenter?
Agenter afslører de krumspring, virksomheder har navigeret uden om i årevis. En stor del af værdien, men også risikoen, ligger her.
Eksemplerne er velkendte:
- Et felt navngivet old i stedet for at blive slettet, som en agent kan læse som omsætningen sidste år, hvis feltet hedder omsætning old.
- En afdeling 999, der bruges som parkeringsplads til ting, der ikke er klar til bogføring.
- Dubletter, der ikke er dubletter: Novo Nordisk A/S, Novo Nordisk med store bogstaver og Novo Nordisk i Bagsværd kan være forskellige virksomheder, man fakturerer hver for sig, men som nogen tror er det samme.
Der er ikke en eneste forretning, der ikke over tid har opbygget en form for teknisk gæld, man opererer uden om. Den lette løsning ville være at kræve, at alt er sat 100 procent korrekt op, men det er ikke den verden, vi lever i. I stedet har man værktøjer. I Fabric skriver man systemprompter, hvor man forklarer krumspringet: at konto 999 har en særlig betydning, eller at man mangler et organisationshierarki og derfor har lagt Novo Nordisk ind på tre kunder. Så forstår AI, at der er krumspring, den skal foretage sig, i stedet for bare at gå den direkte vej. Men det kræver først, at man opdager, at man laver krumspringene. Derfor snakker alle om, at man skal forholde sig til, hvad man faktisk vil opnå, før man går i gang. Man kan ikke altid bare tage en proces og putte AI ovenpå. Man er nødt til at gentænke processen til at blive løst af AI.
Hvordan håndterer man GDPR og adgang?
Grundreglen er, at man ikke skal give en agent adgang til data, man ikke er komfortabel med, at den kigger i. Hvad gør man med et felt, hvor der står, se kommentarer på mail fra Kenneth? Man har en GDPR-udfordring, hvis man giver en agent adgang til alle systemer, medarbejderne arbejder i.
BI-tankegangen er at trække al relevant data ind i et fælles miljø, hvor man sidestiller det, og give agenten adgang til den type data, hvor forarbejdet er lavet. Så forsvinder meget af den slags, der bare siger, se mail fra Kenneth. Er indholdet af mails alligevel relevant, bygger man en integration, der får data ud. Og fordi agenter stadig er non-deterministiske og kan levere data i forskellige formater, foretrækker BI at forme data ud fra en forudsigelig proces, før den gives til en agent med mere flydende spilleregler. De to primære formål med AI i BI er at gøre data tilgængeligt bredt i forretningen, som en oversætter, der svarer, uden at du behøver kende kolonnenavnet, og at gøre det samme for andre agenter.
Der er to ting at være opmærksom på ved GDPR. For det første arver agenter i de fleste tilfælde brugerens rettigheder. Har man tidligere skjult ting rent visuelt, men brugerne har haft adgang til dem, så har brugerne nu adgang via AI. For det andet afhænger overvejelsen af use casen. En agent på BI-data til hele organisationen er én slags udfordring. En personlig e-mailsekretær, der læser dine mails inden for EU Data Boundaries, er en anden. I de tidlige dage gav nogen agenter adgang på rodniveau til deres egen maskine, hvad man kan få udfordringer med.
Hvem ejer en AI-agent?
Ejerskabet bør ligge hos forretningen, ikke hos IT. Der bliver ofte forskel på, hvem der ejer IT-systemet, og hvem der ejer de agenter, der behandler data i det. IT kan eje CRM-systemet eller fil-storagen i SharePoint, men brugerne bygger agenter i Copilot Studio. Hvem bestemmer så?
Det læner sig op ad BI-konceptet dataprodukter og ejerskab over dem, som skal defineres på forretningsplan. Taler man finanstal, er der typisk en, der ved præcis, hvad sandheden er, og den person ejer dataproduktet finansrapportering. Så går det ikke, at en agent ejes af en anden, der giver ikke-identiske svar. Man er nødt til at kridte nogle swimlanes op, og agenten bør høre til i samme produktområde som de brugere, den arbejder for. Agenten skal betragtes som en bruger i sin træk og behandling af data. Ellers risikerer man det værst tænkelige i BI: parallelle, forskellige sandheder. Der må helst kun eksistere én sandhed i en forretning.
Anbefalingen er derfor, at når IT ejer systemet og forretningen ejer data, skal forretningen tage ejerskabet af agenten. IT kan hjælpe med værktøj eller finde en partner, men holdningen til, hvad sandheden er, skal bo hos forretningen.
Hvor skal man starte?
Start småt: kig i dine data og definer et relativt lille område, ikke hele forretningen på én gang. Får man sine data samlet i et system som Fabric, hvor måleenheder er defineret hårdt i kode og ikke tilfældige, og giver agenten adgang til det, skal man være klar på at slå sig. Agenten vil highlighte de steder, hvor brugere stiller spørgsmål og får forkerte svar.
Så skal man være klar til at omstille og korrigere for de udokumenterede interne løsninger, smide alias på og lade datamodellen være levende, så den reelt kommer til at passe til forretningen. Når man mener, at man får gode svar i høj grad og ikke oplever problemer, kan man begynde at brede den ud, både i antallet af brugere og i, hvad den kan, og hvilke data den har adgang til.
Ofte stillede spørgsmål
Hallucinerer moderne AI-modeller stadig?
Sjældnere end folk tror. Det, mange oplever som hallucinationer, er ofte, at de ikke forstår den kontekst, agenten svarer ud fra. Nyere modeller opfinder ikke frit et CVR-nummer, men bruger den viden, de har, eller siger, at de ikke kan svare.
Hvad betyder garbage in, gospel out?
Det betyder, at dårlige data giver et forkert svar, som brugeren opfatter som sandt. AI fylder hullerne ud og giver et bud, der ser generelt korrekt ud, og en bruger uden baggrundsviden opfatter det som valid information.
Hvad er forskellen på aktuelle og gyldige data?
Aktuelle data er opdaterede data, hvor opdateringsmekanismen ikke er stoppet. Gyldige data er data, hvor forretningens logik og termer er fastlagt, så fakturering og profit betyder en bestemt ting.
Hvad er semantisk entydighed?
Semantisk entydighed er, at fagtermer betyder det samme på tværs af systemer. Kunder, accounts og firmaer kan være samme ting for et menneske, men tre forskellige ting for en agent, hvis det ikke er defineret.
Hvem bør eje en AI-agent i en virksomhed?
Forretningen bør eje agenten, mens IT kan eje systemet og stille værktøj til rådighed. Ejerskabet af dataproduktet og holdningen til, hvad sandheden er, skal bo hos forretningen, så der kun findes én sandhed.